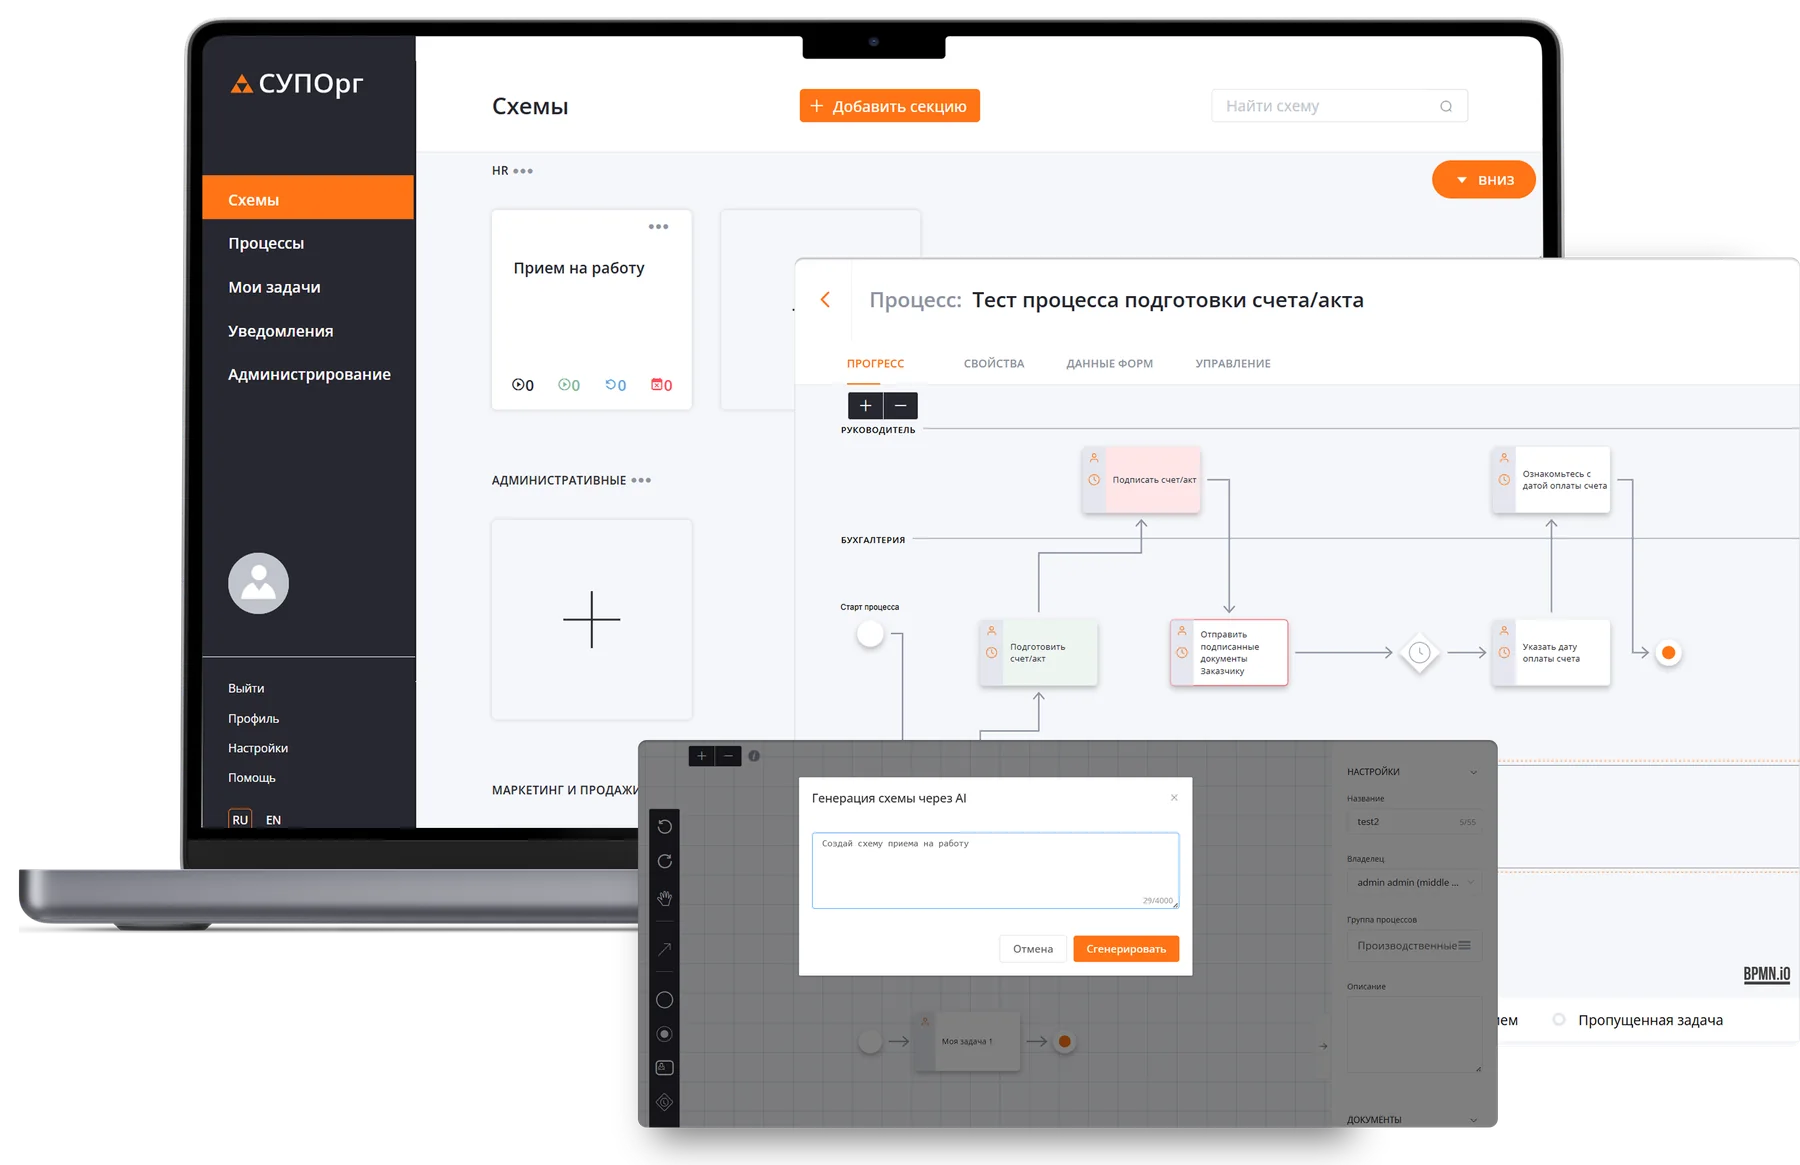
Модели и API
Подключаем GPT, Claude, DeepSeek, YandexGPT и другие модели через единый OpenAI-совместимый интерфейс. Если в одной системе нужны разные провайдеры, подключаем LiteLLM для переключения моделей без переработки прикладной логики.
Внедрение AI: автоматизация, сервисы и анализ данных.
Встраиваем мультимодальных ассистентов, поиск по базе знаний и обработку документов в корпоративные порталы, веб-сервисы и внутренние ИС — на ваших данных и с учётом прав доступа. Полноценный AI-функционал OpenAI внутри ваших приложений.
Создаём ассистентов для поиска по базам знаний и внутренним документам. Они отвечают на вопросы со ссылками на источники и учитывают роли и права доступа пользователей.
Подключаем языковые модели к корпоративным данным. Пользователь задаёт вопросы на естественном языке и получает анализ, выводы, дашборды и готовые файлы.
Настраиваем строгий формат ответа, чтобы модель возвращала данные заданной структуры и запускала дальнейший процесс. Такой подход позволяет использовать AI в уже существующей функциональности.
Разрабатываем модели для прогнозирования временных рядов, классификации и поиска закономерностей в данных. Подбираем методы под задачу, характер данных и требования к точности результата.
Подключаем GPT, Claude, DeepSeek, YandexGPT и другие модели через единый OpenAI-совместимый интерфейс. Если в одной системе нужны разные провайдеры, подключаем LiteLLM для переключения моделей без переработки прикладной логики.
Выносим AI-функции в отдельный сервис на Python и разворачиваем его рядом с основным приложением, в том числе как независимый компонент в Kubernetes. Такой подход ускоряет внедрение и сводит изменения в существующей системе к минимуму.
Создаём быстрый поисковый контур на Elasticsearch, векторных индексах и Redis. Объединяем полнотекстовый и семантический поиск, храним контекст диалога.
Отслеживаем расход токенов и стоимость по пользователям, ролям и сценариям. Настраиваем доступ к моделям, защищаем чувствительные данные и ведём журнал запросов.
01 / 02
Цифровая платформа для анализа, мониторинга и управления производственными показателями.
Подробнее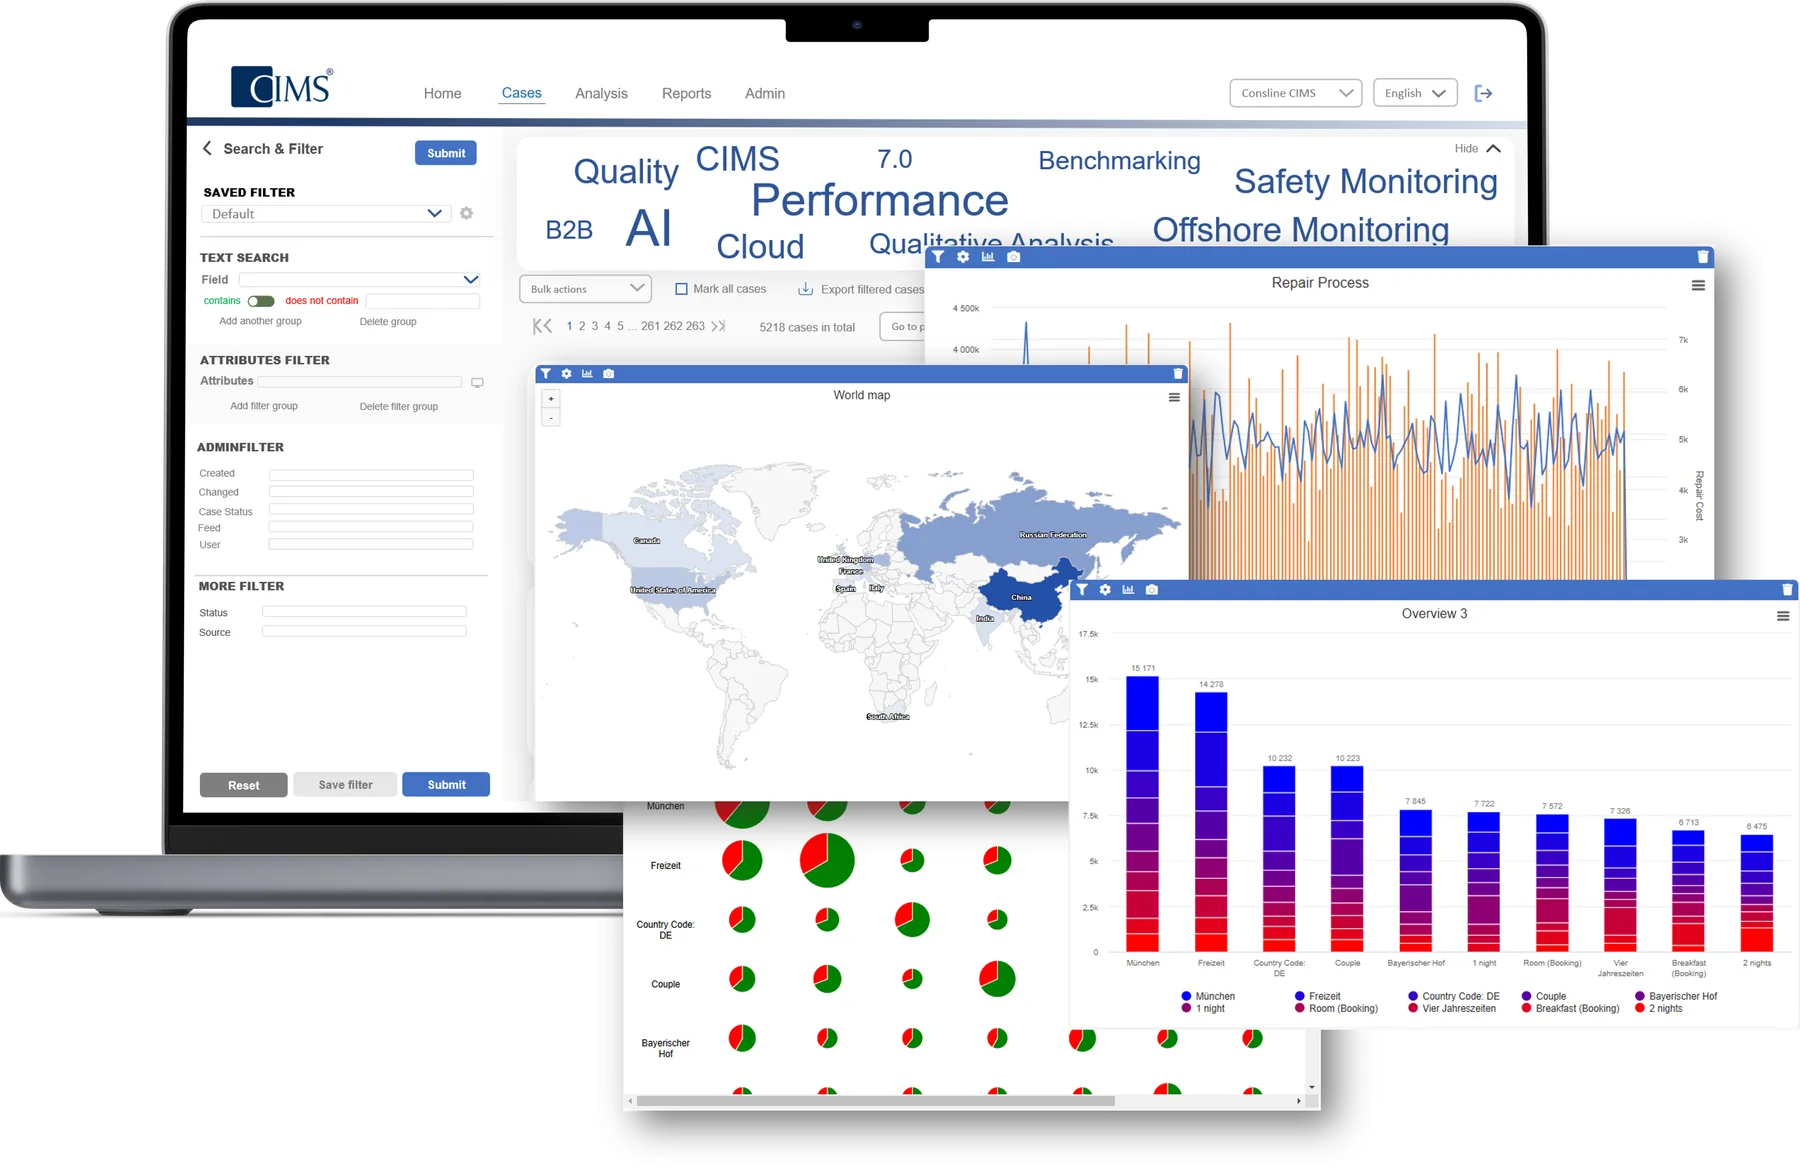
Зависит от того, могут ли они покидать ваш контур. Если не могут — разворачиваем решение на вашей стороне, на моделях, работающих локально. Если могут — фиксируем документом, какие именно данные передаются, куда и на каком этапе. Разграничение доступа закладываем на уровне архитектуры: ассистент отвечает пользователю только по тем источникам, к которым у него есть права.
Прайса нет: стоимость одного и того же сценария отличается в разы. Сильнее всего влияет состояние данных — если они разрознены или неполны, основная работа уходит на их подготовку, а не на модель. Дальше — требования к контуру и глубина интеграции с вашими системами. Оценку даём после разбора сценария; до него любая цифра была бы выдумкой.
Описание процесса, который хотите автоматизировать, и примеры данных — документов, обращений, запросов. Готового технического задания не требуется, при необходимости составим его вместе. Ещё нужен один человек со стороны бизнеса, который знает процесс и может отвечать на вопросы: без него проект встаёт быстрее, чем из-за любых технических сложностей.
Поэтому мы и начинаем с ограниченного объёма. Пилот заканчивается метриками на ваших данных и решением продолжать или нет. Отрицательный результат — тоже результат: вы не вкладываетесь в сценарий, который на ваших данных не работает, и узнаёте об этом через несколько недель, а не через год.
Да, мы работаем через интеграционный слой. Перед началом смотрим, какие точки интеграции есть: API, доступ к данным, аутентификация. Если их нет, это отдельная задача — и мы скажем об этом на этапе разбора, а не в середине проекта.
Исходный код, документация и доступы — они ваши с первого дня, а не после финальной приёмки. Решения по архитектуре описываем так, чтобы систему могла поддерживать другая команда: ваша или сторонняя.